先说清楚:本地能跑的是哪个 DeepSeek
DeepSeek 官网和 App 里用的是满血版大模型,参数量几百 B 起步,光模型文件就要几百 GB,个人电脑跑不动。DeepSeek 最新的 V4 系列在 Ollama 上也只提供云端版本。
大家说的「本地部署 DeepSeek」,一般指 DeepSeek-R1 蒸馏版:DeepSeek 把 R1 的推理能力蒸馏到 Qwen、Llama 等较小的模型上,从 1.5B 到 70B 都有,普通电脑也能跑。能力比满血版弱,但日常问答、写作、翻译和整理资料够用。
选哪个版本:看你的电脑配置
| Ollama 版本 | 模型大小 | 建议配置(经验值) | 适合 |
|---|---|---|---|
| deepseek-r1:1.5b | 1.1 GB | 8GB 内存,无独显也能跑 | 尝鲜,效果一般 |
| deepseek-r1:7b / 8b | 4.7 / 5.2 GB | 8GB 显存,或 16GB 内存的 Mac | 大多数人的首选 |
| deepseek-r1:14b | 9 GB | 12GB 以上显存,或 32GB 内存的 Mac | 写作、分析质量明显更好 |
| deepseek-r1:32b | 20 GB | 24GB 显存,或 48GB 以上内存的 Mac | 接近云端效果 |
| deepseek-r1:70b | 43 GB | 64GB 以上内存的 Mac 或多张显卡 | 工作站 |
| deepseek-r1:671b | 404 GB | 服务器级硬件 | 个人电脑不建议 |
拿不准就先装 8b,跑得顺再往上换。Mac 的内存和显存是共用的,所以同样大小的内存,Mac 能跑的模型通常比 Windows 笔记本大一档。
第 1 步:安装 Ollama
打开 ollama.com/download,下载对应系统的安装包,装好后 Ollama 会在后台运行。Linux 可以直接运行:
curl -fsSL https://ollama.com/install.sh | sh
第 2 步:下载 DeepSeek 模型
打开终端(Windows 用 PowerShell),输入下面这行命令,把 8b 换成你选的版本:
ollama pull deepseek-r1:8b
下载完成后运行 ollama list,能看到 deepseek-r1:8b 就说明装好了。
第 3 步:在 Cherry Studio 里接入
在终端里也能和模型聊天,但看不了历史记录,也传不了文件。装一个 Cherry Studio,用起来就和 DeepSeek App 差不多:
- 免费下载 Cherry Studio 并安装。
- 打开 设置 → 模型服务,选中 Ollama,打开右上角的开关。API 地址保持默认的
http://localhost:11434,API 密钥留空即可。 - 点 管理 或 + 添加,把
deepseek-r1:8b加进模型列表。 - 回到聊天页,在顶部模型下拉框选择 deepseek-r1:8b,就可以开始聊了。R1 的思考过程会单独折叠显示,不会和答案混在一起。
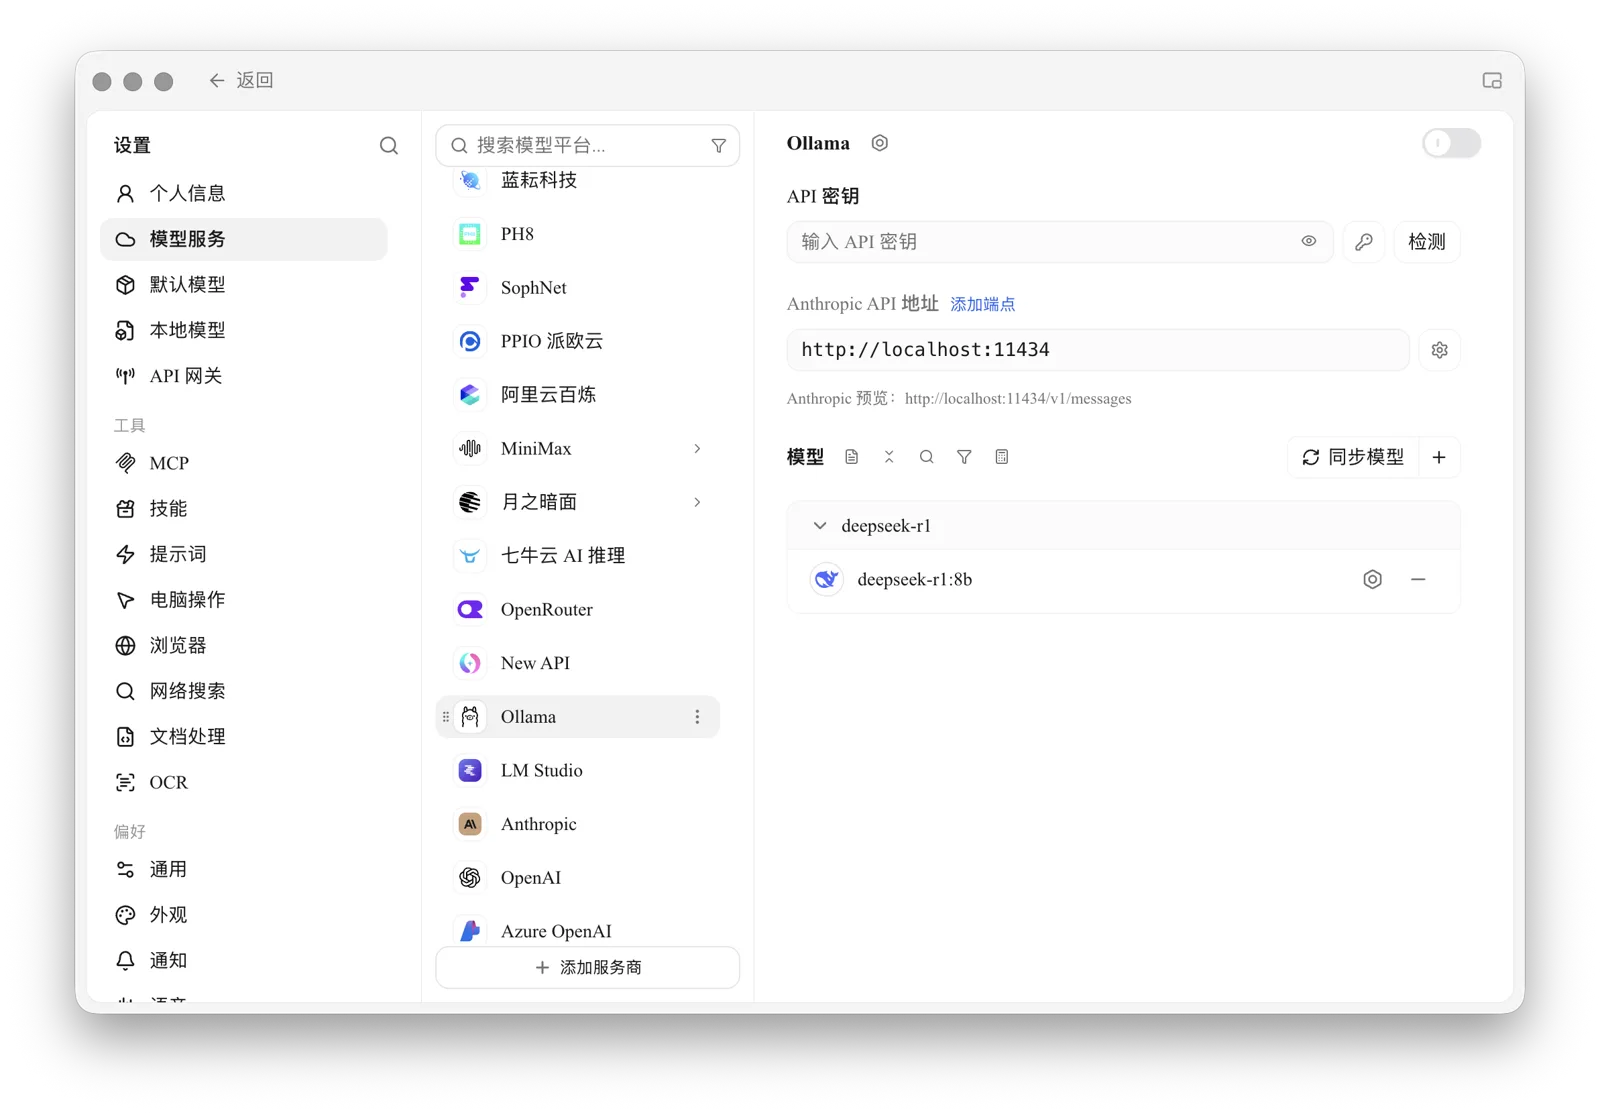
更详细的设置说明见 Ollama 接入教程。
进阶:用本地 DeepSeek 读你自己的文件
只聊天有点浪费本地部署的优势。在 Cherry Studio 里建一个知识库,把 PDF、Word、笔记放进去,再配一个本地嵌入模型(比如 ollama pull bge-m3),就能在本机完成向量化。处理合同、内部资料等不能外发的内容时,解析、OCR、重排和聊天也要使用本地能力,并避免调用会向外部发送内容的工具。即使嵌入在本地完成,云端服务仍可能收到文件或召回片段。(详见创建知识库和数据、隐私与维护)
想更进一步,还可以让本地模型当 Agent,在指定的文件夹里整理文件、写报告。小模型做多步骤任务比较吃力,建议用 14b 以上的版本。如果切到云端模型,对话上下文或工具结果中包含的文档内容就会发送给该服务商。(详见 Agent 工作区)
本地部署和直接用 API,怎么选
本地部署的好处是免费、离线可用、数据不出电脑;代价是吃硬件,效果也比不上满血版。如果你更在意效果、不介意数据发给服务商,直接用 DeepSeek 官方 API 或硅基流动这类平台,价格很便宜。
在 Cherry Studio 里不用二选一:本地版和 API 版可以同时加进来,敏感内容用本地模型,难题切到满血版,下拉框一换就行。
给本地 DeepSeek 配一个好用的聊天界面
Cherry Studio 免费开源,支持 Windows、macOS 和 Linux。连上 Ollama 就能用本地 DeepSeek 聊天、读文件、跑 Agent,聊天记录都存在自己电脑上。
常见问题
本地部署 DeepSeek 需要显卡吗?
不是必须的。1.5b、7b 用 CPU 也能跑,只是慢一些。有 8GB 以上显存的显卡,或者用 Apple 芯片的 Mac,体验会好很多。
本地部署后断网还能用吗?
能,前提是所需模型已下载,解析、OCR、嵌入、重排和聊天都使用本地能力。需要外部服务的工具仍然需要联网。
本地的 DeepSeek 和官网的一样吗?
不一样。本地跑的是 R1 蒸馏版,参数量小很多,复杂推理和长文写作会比官网弱。
Ollama 下载模型很慢怎么办?
可以换个时间段重试,或者改用 LM Studio 下载模型,Cherry Studio 同样能接入(见接入 LM Studio)。