文档解析与 OCR
知识库只能检索已经解析出的文字。扫描 PDF、双栏论文、复杂表格和图片型页面,先把正文解析正确,再调整模型和召回参数。
先判断资料类型
| 资料类型 | 推荐起点 | 必查内容 |
|---|---|---|
| Markdown、TXT、HTML | 默认读取 | 标题层级、编码、换行 |
| 可复制文字的 PDF、DOCX、PPTX | 先用默认处理 | 段落顺序、页眉页脚、表格 |
| 扫描 PDF、截图、图片型页面 | 本地或系统 OCR | 识别语言、金额、日期、编号 |
| 多栏、公式或复杂表格 PDF | 专用文档处理器 | 阅读顺序、表格结构、脚注 |
解析在检索链路中的位置
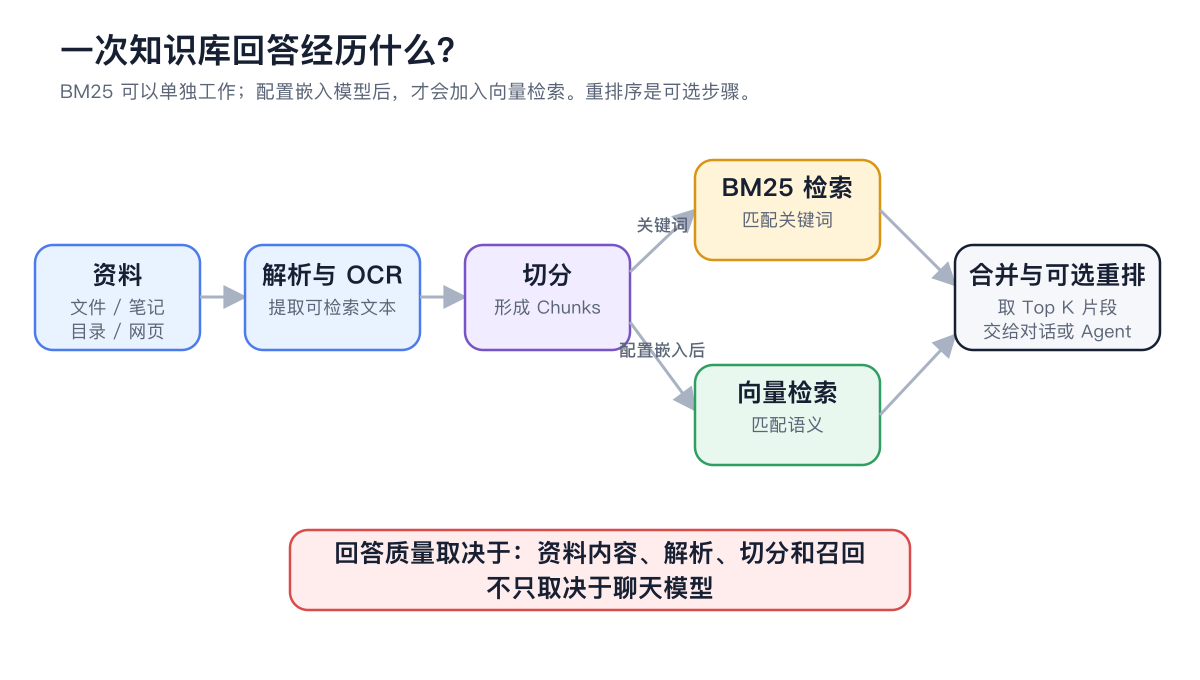
解析错误会继续传到分块和召回;下游模型无法恢复从正文中已经丢失的内容。
配置并验收一份样本文档
1. 选择代表性样本
不要先导入整批资料。选一份最能暴露问题的文档,例如带表格的扫描 PDF 或双栏说明书。
2. 配置处理能力
打开【设置】→【文档处理】,按需要配置文档解析服务和 OCR。云端服务通常需要 API Key 或服务地址;本地能力可能需要先下载模型。
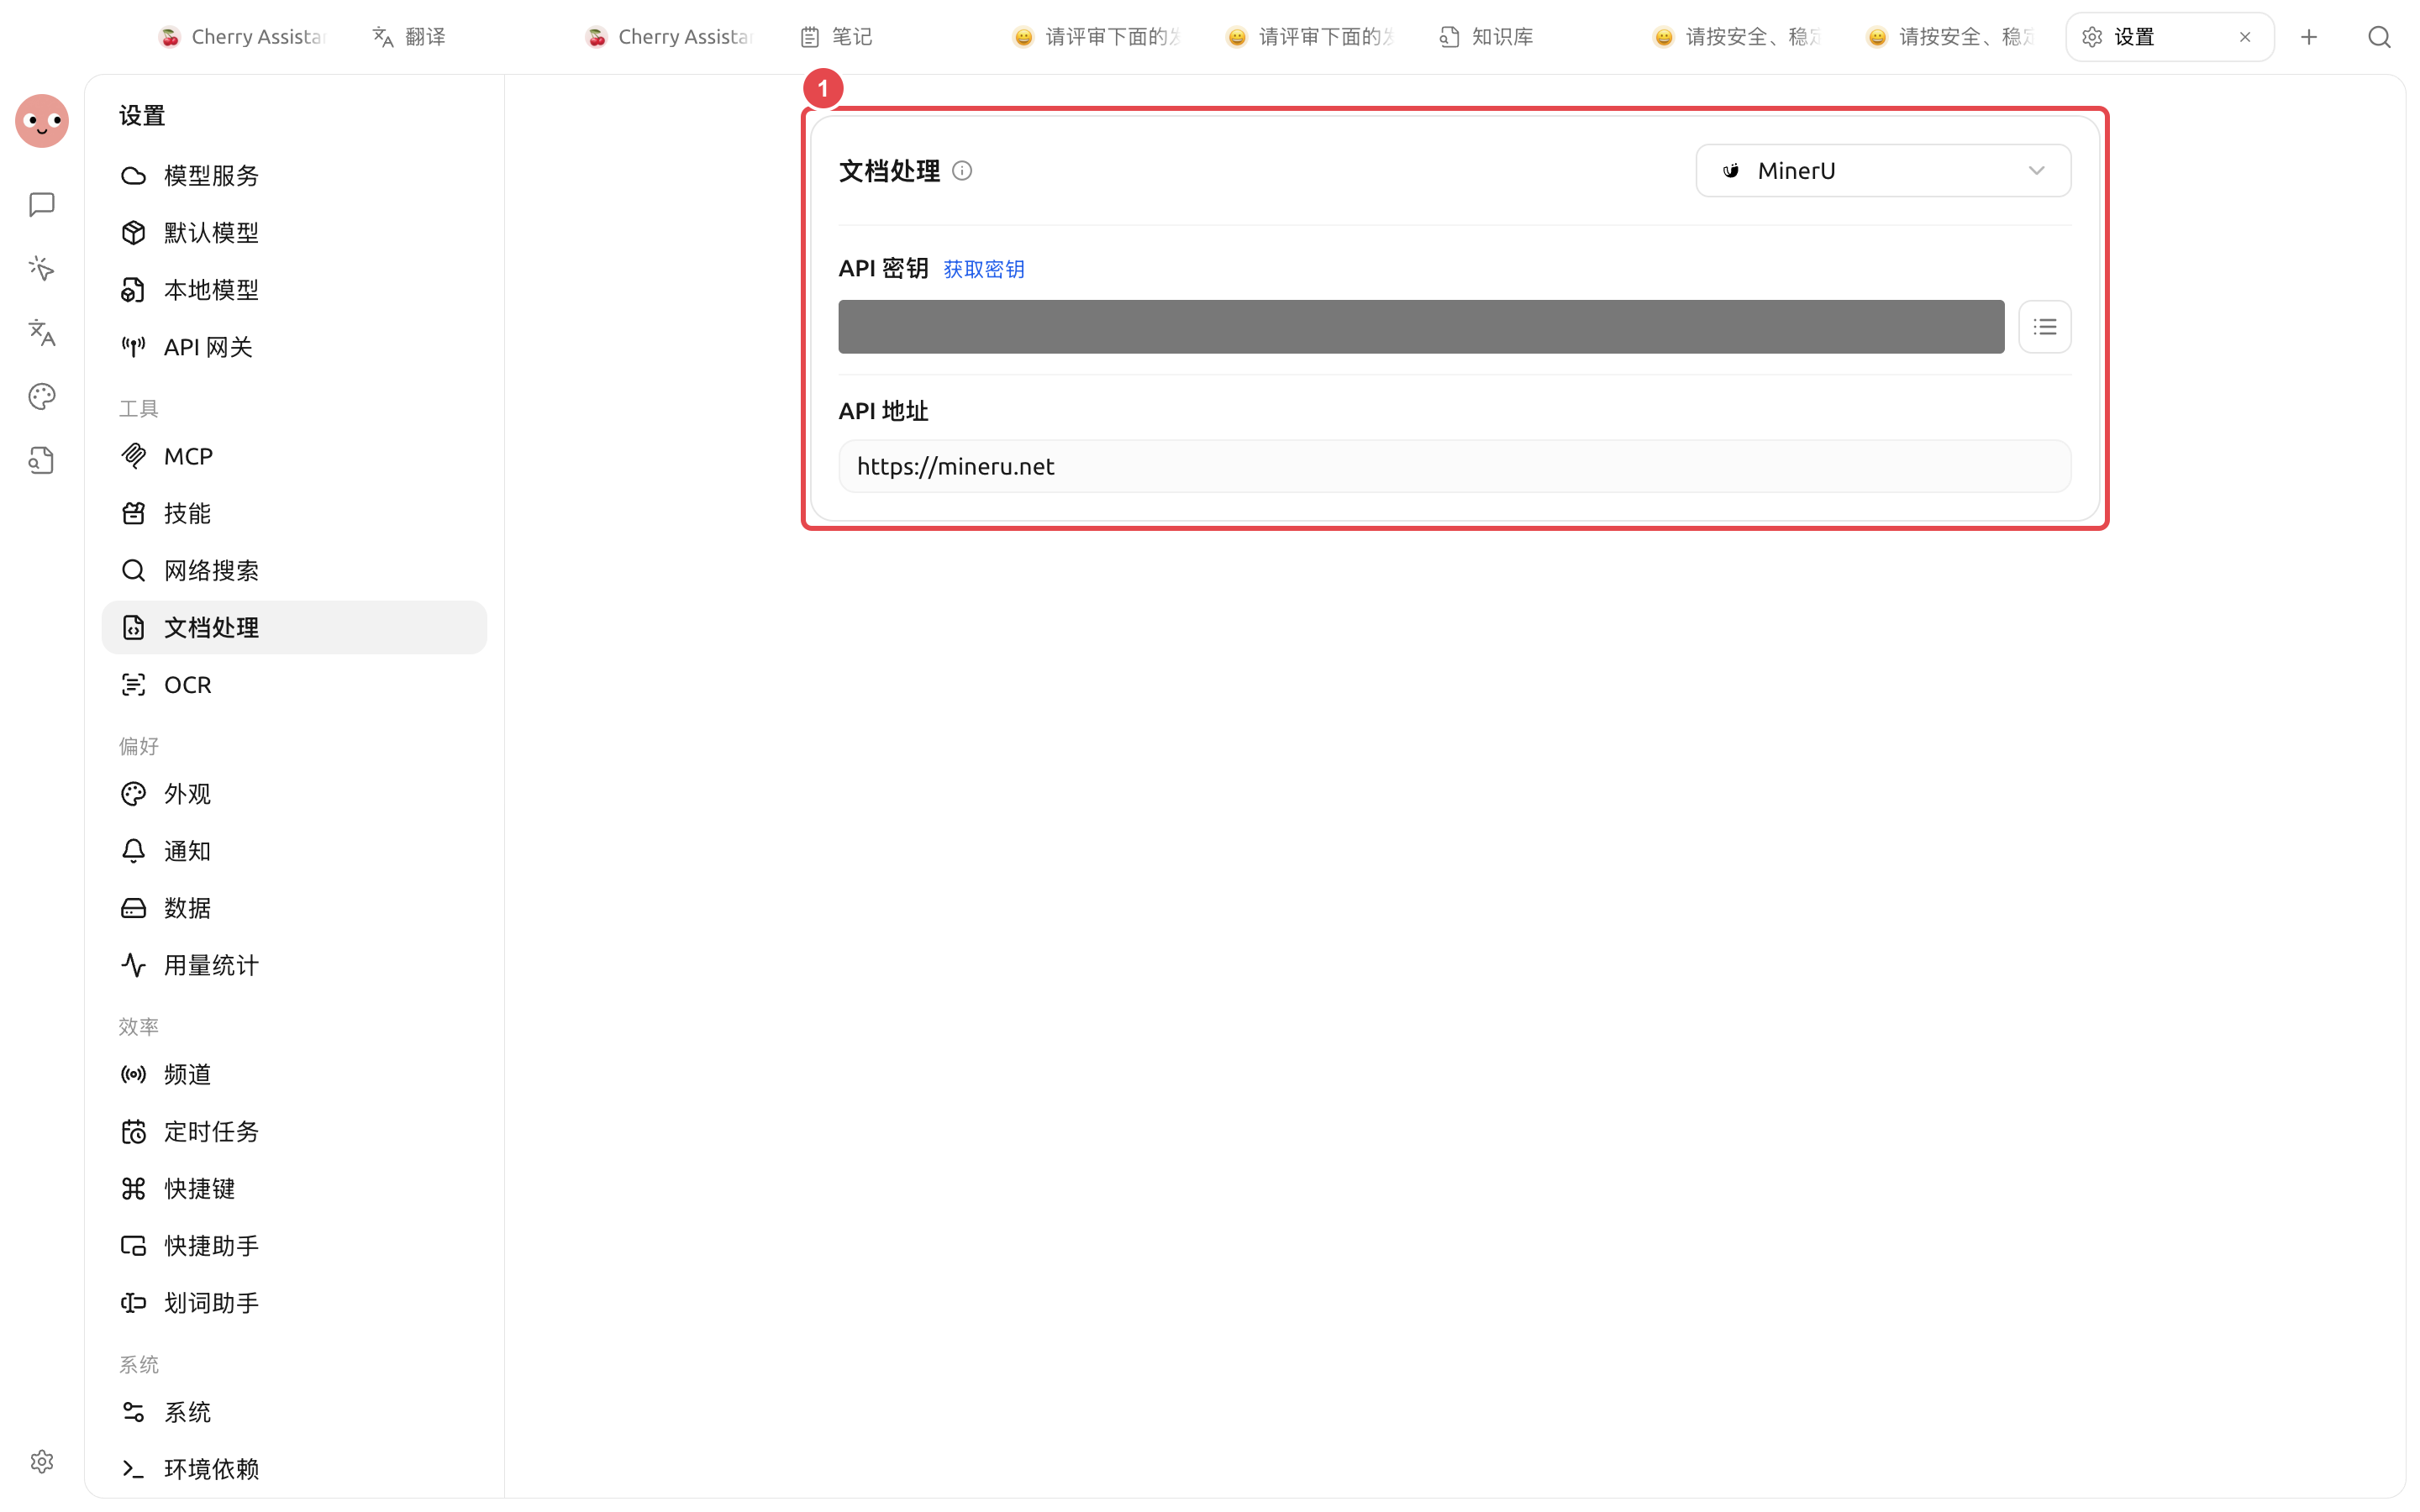
先把要使用的服务配置到可用状态,再回到知识库选择处理器。
3. 导入并等待就绪
把样本文档添加到知识库。处理完成后打开正文,检查标题、段落、页码、表格和 OCR 文字。
4. 检查 Chunks
确认关键条件与结论没有被拆散;页眉、页脚和目录不要大量重复占用片段。
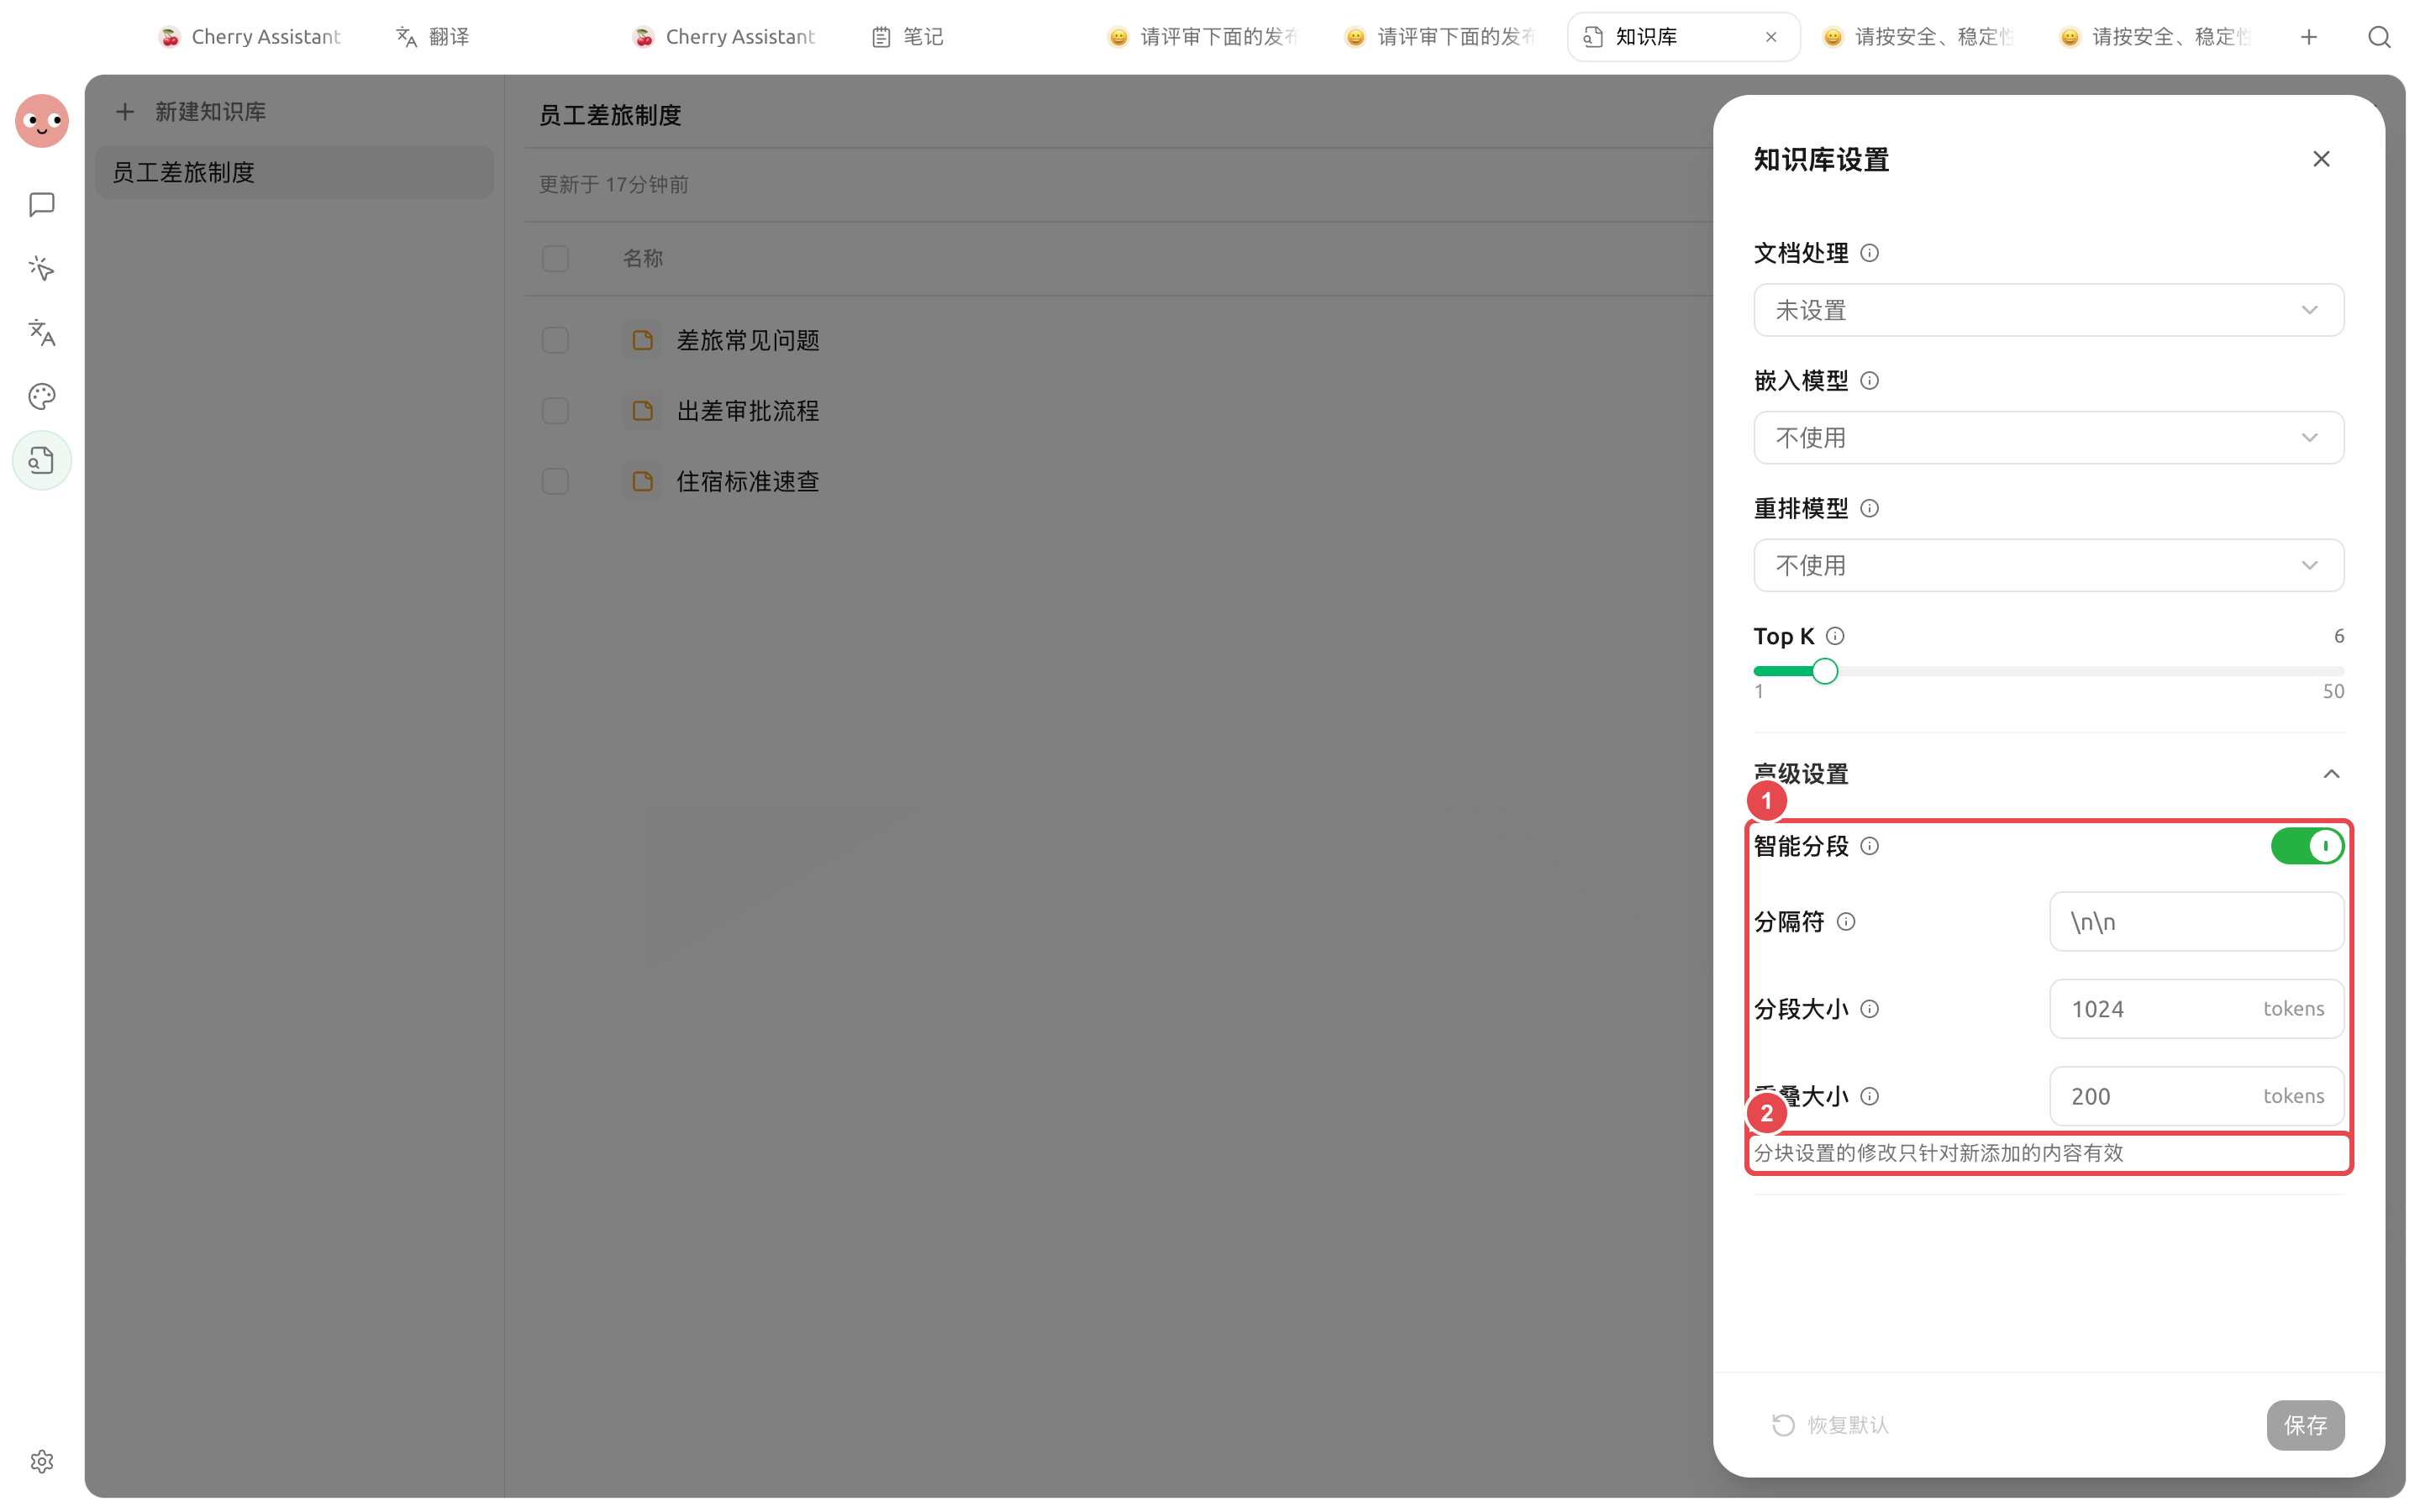
正文正确后再检查分块;解析错误不能靠增大 Chunk 修复。
5. 用真实问题复测
在【召回测试】中输入一个答案位于该文档中的问题。结果应包含正确来源、完整条件和关键数字。
6. 固定方案再批量导入
样本合格后,再把同类型资料分批导入。处理器、OCR 或分块设置改变后,对旧资料执行【重新索引】并重复测试。
处理器与 OCR 怎么选
| 选择 | 适用情况 | 优点 | 注意事项 |
|---|---|---|---|
| 默认读取 | 文本型常见格式 | 配置少、速度快 | 复杂排版和扫描页可能丢失内容 |
| System OCR | 系统支持且图片清晰 | 无需额外 API Key、速度快 | 准确率取决于操作系统、语言和图像质量 |
| 本地 PaddleOCR | 需要离线识别 | 文档不离开本机 | 首次使用前需要下载本地模型 |
| 云端或自托管处理器 | 双栏、复杂表格、公式较多 | 版面分析能力通常更强 | 云端方案会接收用于处理的文档内容 |
典型问题怎么定位
| 表现 | 先检查 | 处理方向 |
|---|---|---|
| 正文为空或很短 | 文件是否为扫描件 | 启用 OCR 或更换处理器 |
| 双栏文字交错 | 正文阅读顺序 | 使用擅长版面分析的处理器 |
| 表格变成零散文字 | 表头、行列关系 | 更换处理器,或把关键规则整理成 Markdown 笔记 |
| 页眉页脚反复出现 | Chunks 中的重复噪声 | 清理源文件或换解析器,不要只提高 Top K |
| OCR 数字出错 | 金额、日期、编号 | 提高图像清晰度并人工核对高风险字段 |
配置说明
| 配置项 | 推荐起点 | 何时调整 | 调整后动作 |
|---|---|---|---|
| 文件处理器 | 先用默认处理 | 正文错序、表格丢失、扫描页为空 | 重新索引样本文档 |
| OCR | 清晰扫描件优先本地或系统能力 | 图片型页面没有文字或错字较多 | 重新索引并核对关键字段 |
| Chunk 大小与重叠 | 先保留知识库默认设置 | 条件与结论被切开 | 每轮只改一项并重新索引 |
| 验收问题 | 3~5 个真实问题 | 更换处理器、OCR 或分块后 | 使用同一问题集比较 |
用户案例
小林导入一份双栏差旅制度 PDF。状态已经就绪,但正文把左右两栏交错在一起,召回结果中的审批条件也不完整。他没有先调高 Top K,而是换用更适合版面分析的处理器,重新索引同一文件,再检查正文和 Chunks。
完成标准是:审批条件按原文顺序可读,金额和日期正确,固定问题能召回包含完整条件的片段。
常见问题
正文正确,还需要看 Chunks 吗?
需要。正文正确只说明解析合格;条件和结论仍可能在切分时被分开。
增加 Top K 能修复解析问题吗?
不能。Top K 只控制返回多少片段,不会恢复正文中已经丢失或错序的内容。
为什么更换处理器后结果没有变化?
旧资料仍在使用原来的索引。对相关条目执行【重新索引】,再用相同问题复测。