检查资料与召回
召回测试直接检查“问题能否找到正确片段”,不会先经过聊天模型润色。它能帮助你判断问题出在资料、解析、分块还是检索设置。
准备测试问题
建议同时覆盖三类问题:
- 精确事实,例如“国内一线城市住宿上限是多少?”
- 条件规则,例如“海外租车在什么情况下可以报销?”
- 容易混淆,例如“5000 元以上的出差由谁追加审批?”
不要只用资料标题或整句原文测试,那会高估真实使用效果。
完成一次召回测试
1. 打开召回测试
打开左侧导航【知识库】→ 选择知识库 → 进入【召回测试】。
2. 输入真实问题
输入一个答案明确的问题并执行测试。问题应接近日常说法,不要刻意复制资料原文。
3. 检查来源和片段
确认来源正确,片段同时包含回答所需的条件和结论。
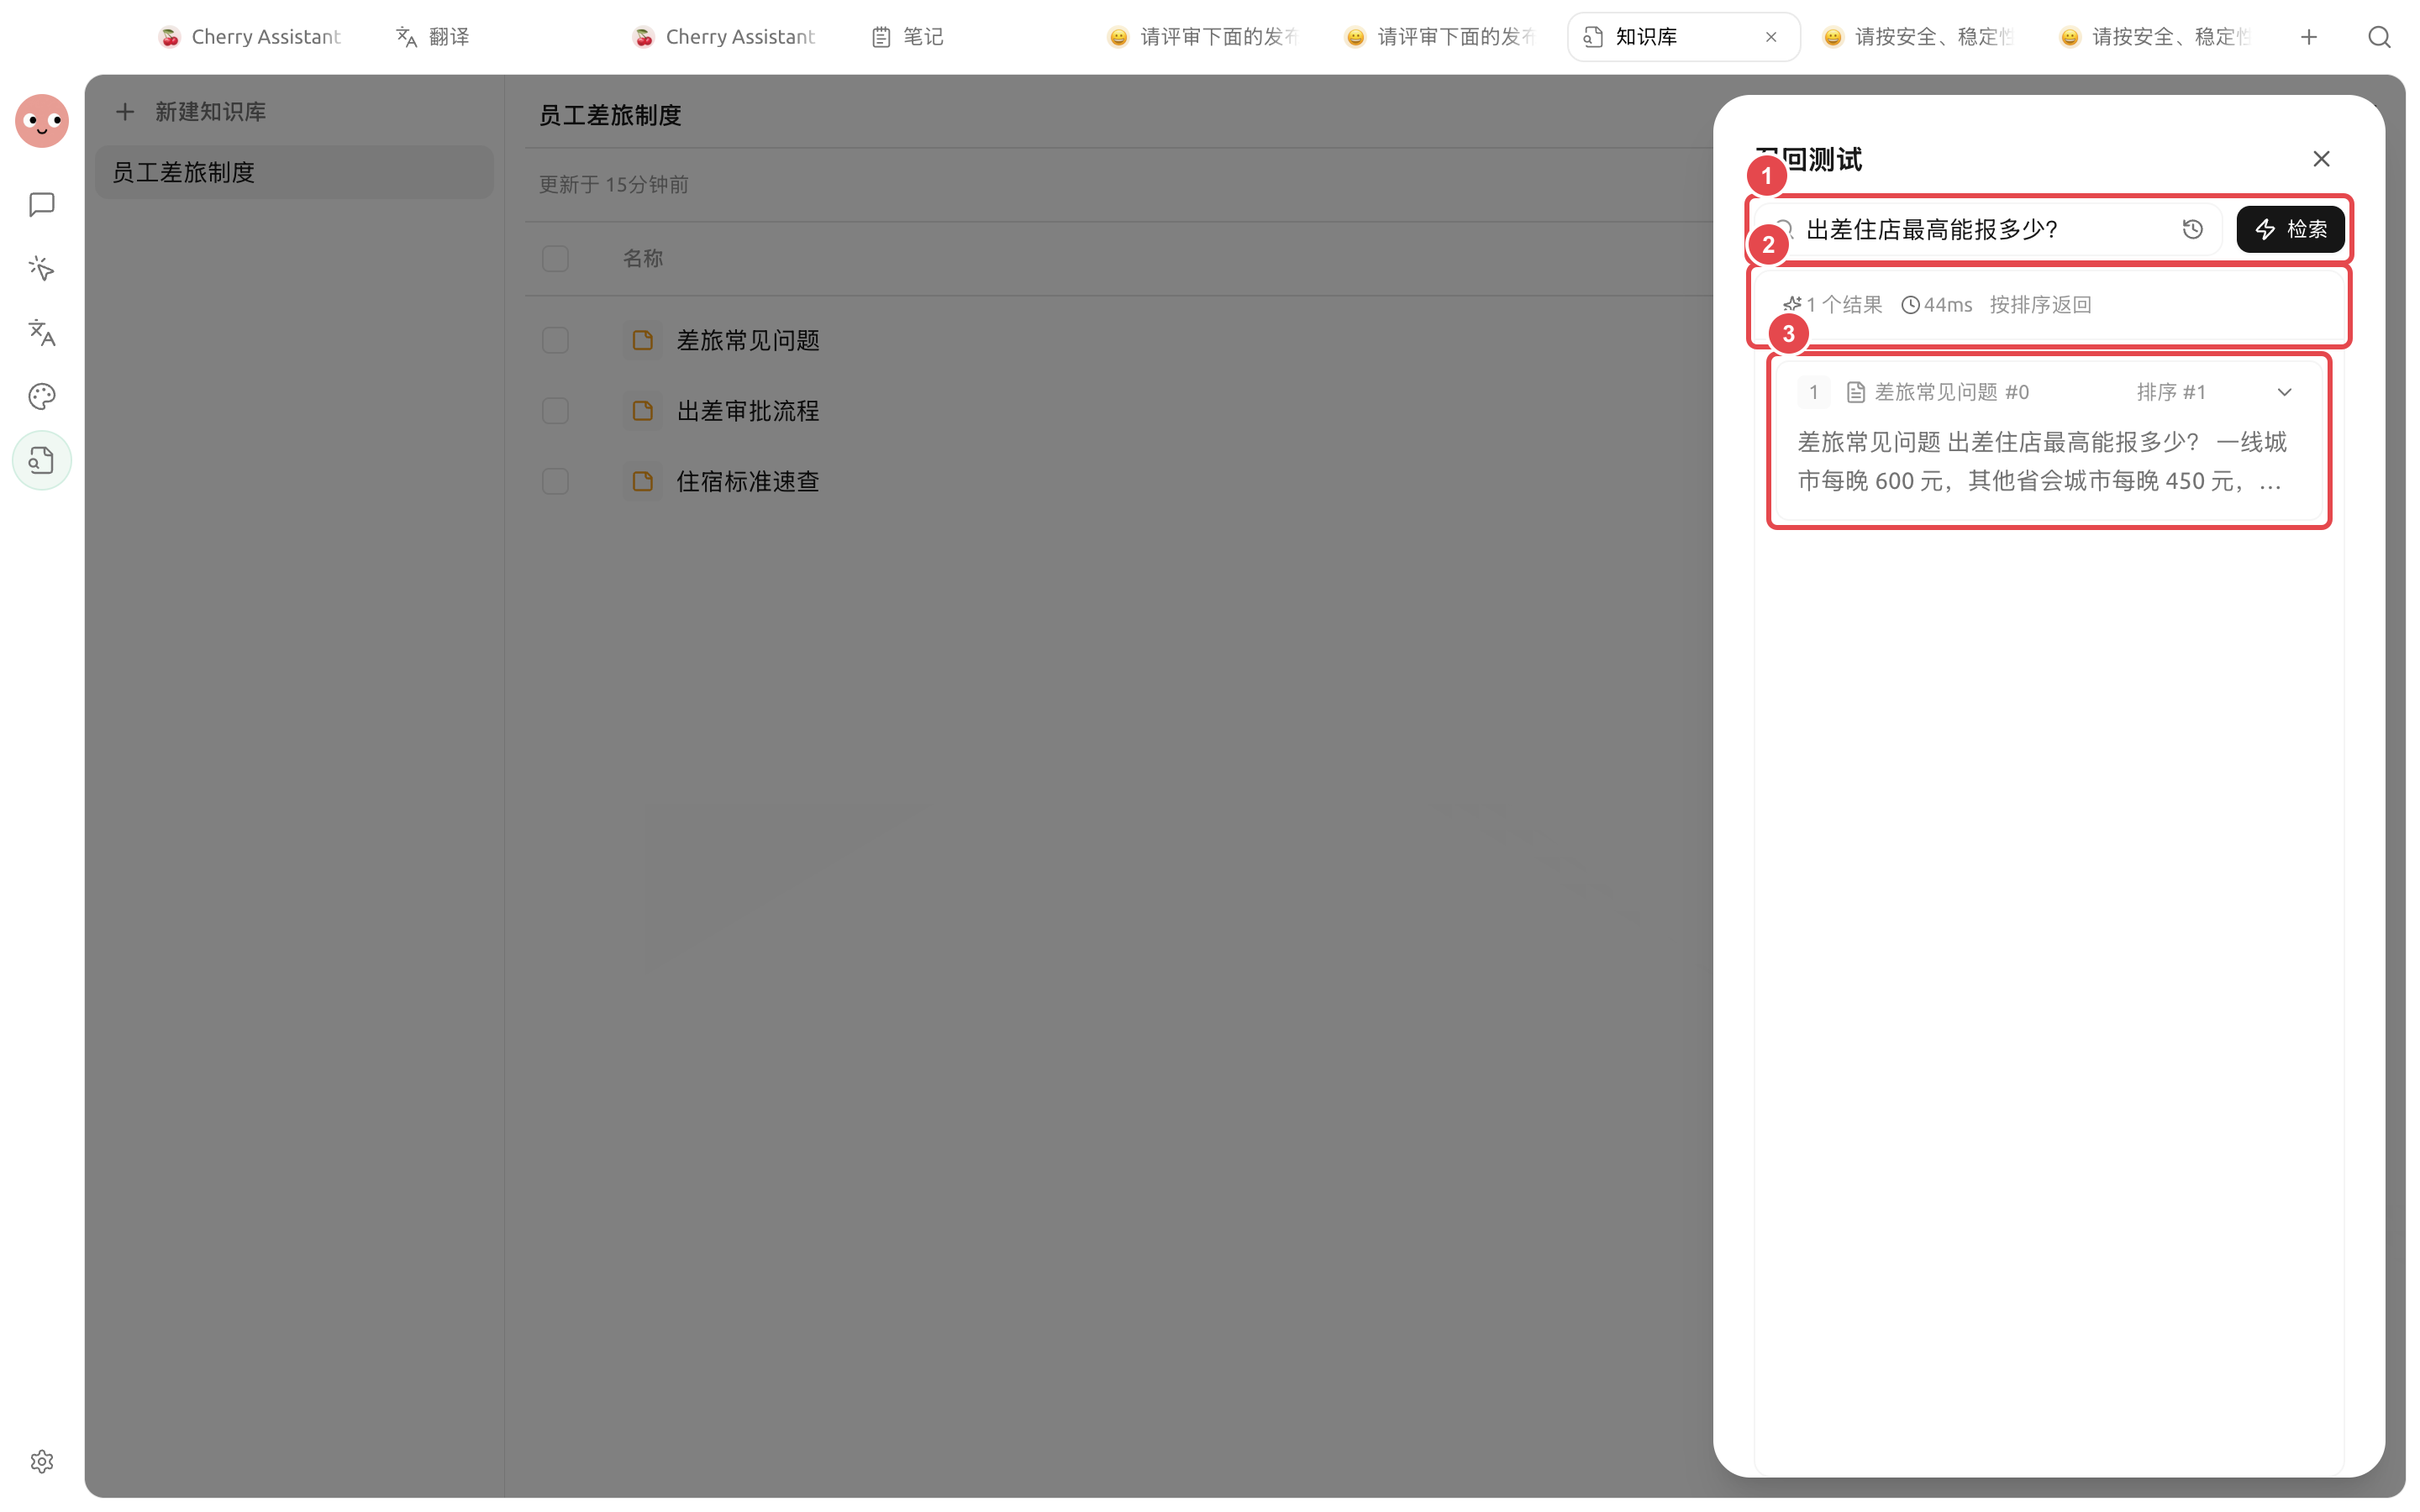
不要只看有没有结果,还要检查来源、片段完整度和顺序。
4. 对照现象定位问题
完全没有正确片段时先查资料、解析和分块;正确片段能出现但顺序不稳时,再考虑嵌入、重排或 Top K。
5. 单项调整并复测
每轮只修改一项设置。涉及解析、分块或索引时,先执行【重新索引】,再使用同一组问题复测。
怎样读结果
| 现象 | 说明 | 下一步 |
|---|---|---|
| 正确来源排在前面,片段完整 | 召回基本合格 | 再测试几种不同问法 |
| 完全没有正确结果 | 资料未就绪、内容缺失、问法差异大或阈值过高 | 依次检查资料、正文、Chunks 和检索设置 |
| 来源正确但片段缺少关键句 | 解析或分块边界不理想 | 查看 Chunks,调整后重新索引 |
| 旧版本和新版本同时出现 | 同名资料被全部保留 | 删除旧条目或用【替换】重新导入 |
| 正确项经常靠后 | 候选较多或排序不稳定 | 清理资料,考虑嵌入或重排模型 |
| 召回正确但聊天回答不准 | 问题更可能在提示词或聊天模型 | 保留召回设置,调整提问和聊天模型 |
调优闭环
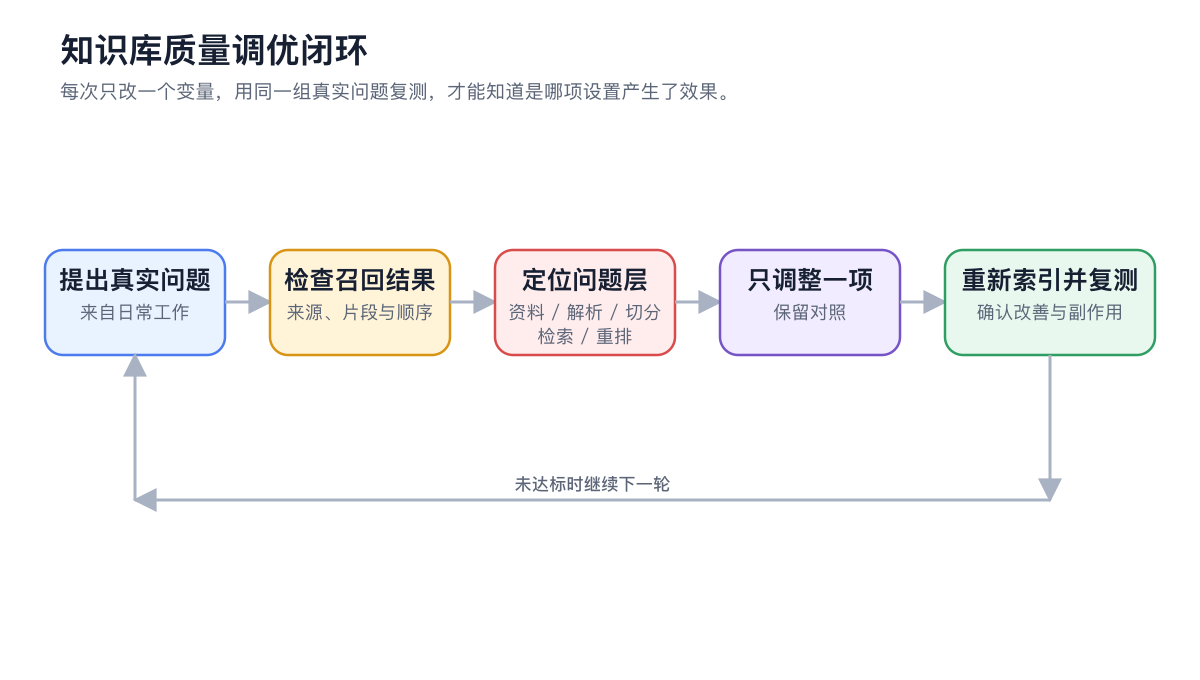
固定问题 → 检查结果 → 定位层级 → 单项调整 → 必要时重新索引 → 复测。
推荐顺序:
- 确认资料正确,没有重复或过期版本。
- 检查解析正文和 Chunks。
- 问法与原文差异很大时,考虑嵌入模型。
- 候选大致正确但顺序不稳时,再考虑重排模型。
- 调整后重新索引,并重复同一组测试。
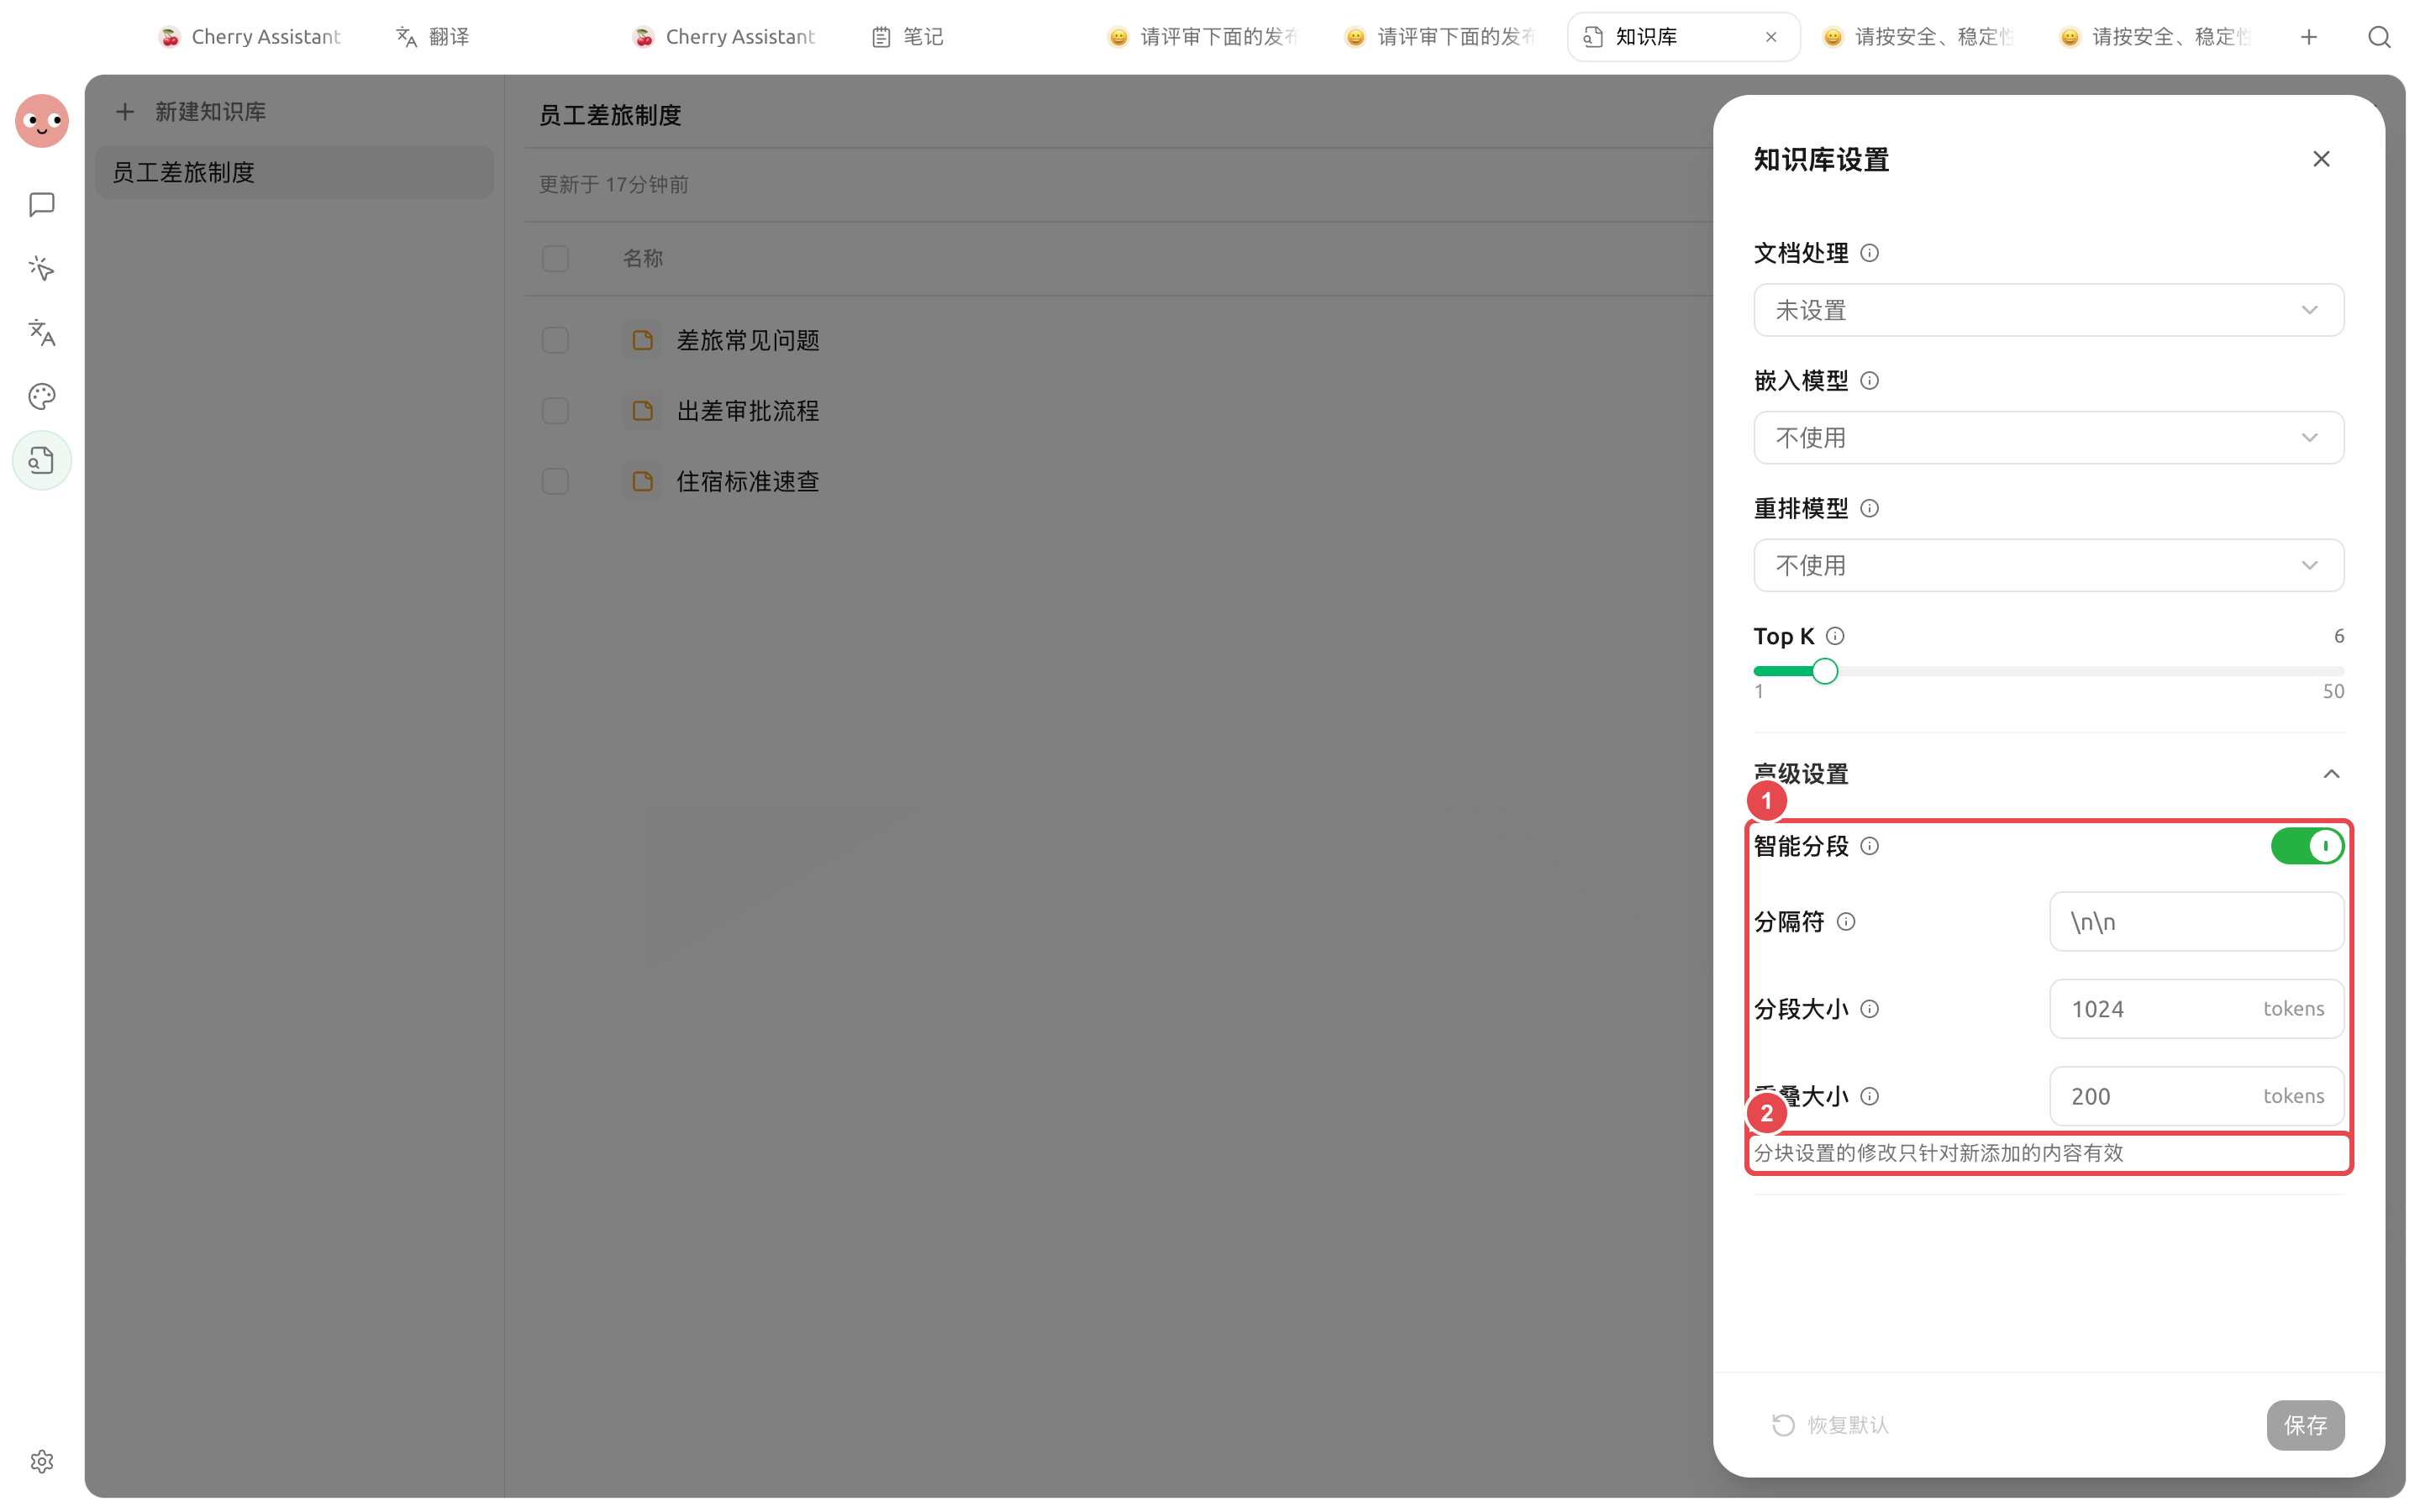
片段不完整时再检查分块设置;修改只影响新资料,旧资料需要重新索引。
配置说明
| 配置项 | 产品默认值 | 建议起点 | 作用 | 适用场景 | 注意事项 |
|---|---|---|---|---|---|
| 测试问题数量 | — | 3~5 个 | 建立可重复的质量基线 | 所有知识库 | 覆盖精确事实、条件规则和易混淆问题 |
| Top K | 6,可选 1~50 | 先保留 6 | 控制最终片段数量 | 覆盖与噪声之间取舍 | 调大可能占用更多上下文 |
| 相似度阈值 | 0.0,仅配置重排后显示 | 从 0.0 开始 | 过滤重排后的低分结果 | 重排后仍有噪声 | 设得过高会移除正确片段 |
| 复测方式 | — | 每轮只改一项 | 判断设置变化来自哪里 | 调优、更新资料或模型 | 修改分块或模型后先重新索引 |
预期结果
- 正确来源稳定出现在前几条结果中。
- 片段包含回答问题所需的条件和结论。
- 换一种自然说法后,结果仍然稳定。
- 更新资料或设置后,固定问题没有明显退化。
用户案例
小林发现“住宿费标准”用原文能命中,但“住酒店最多能报多少”不稳定。他先确认资料和 Chunks 正常,再配置嵌入模型并复测。正确片段出现后偶尔排在后面,于是才加入重排模型。
完成标准是:三种不同问法都能在前几条结果中找到同一条住宿标准,且片段包含适用城市和金额上限。
常见问题
完全没有正确片段,先调大 Top K 吗?
先检查资料正文和 Chunks。解析或切分错误时,调大 Top K 只会返回更多不正确或不完整的片段。
为什么看不到相似度阈值?
只有选择重排模型后,知识库设置中才会显示【相似度阈值】。
召回正确,聊天回答仍不准确怎么办?
保留当前召回设置,检查问题表达、对话上下文和聊天模型。此时问题通常已经不在资料检索层。